みなさん、こんにちは。64歳のプログラマーです。
9月に開催されるNAIST(奈良先端大)のオンライン学生募集説明会を控え、受験に向けて避けて通れない大きな壁があります。それが、出願時に提出する「小論文(研究計画書)」の存在です。
試験官であるバイオ専門の教授陣に、私の40年のITキャリアをどうアピールすべきか。
私はピペット(実験器具)を握ったこともなければ、細胞を培養したこともありません。ウェットの実験室では完全な「未経験の新人」です。
しかし、「データのバグを執念でデバッグする」ということなら、40年間誰よりもやってきました。
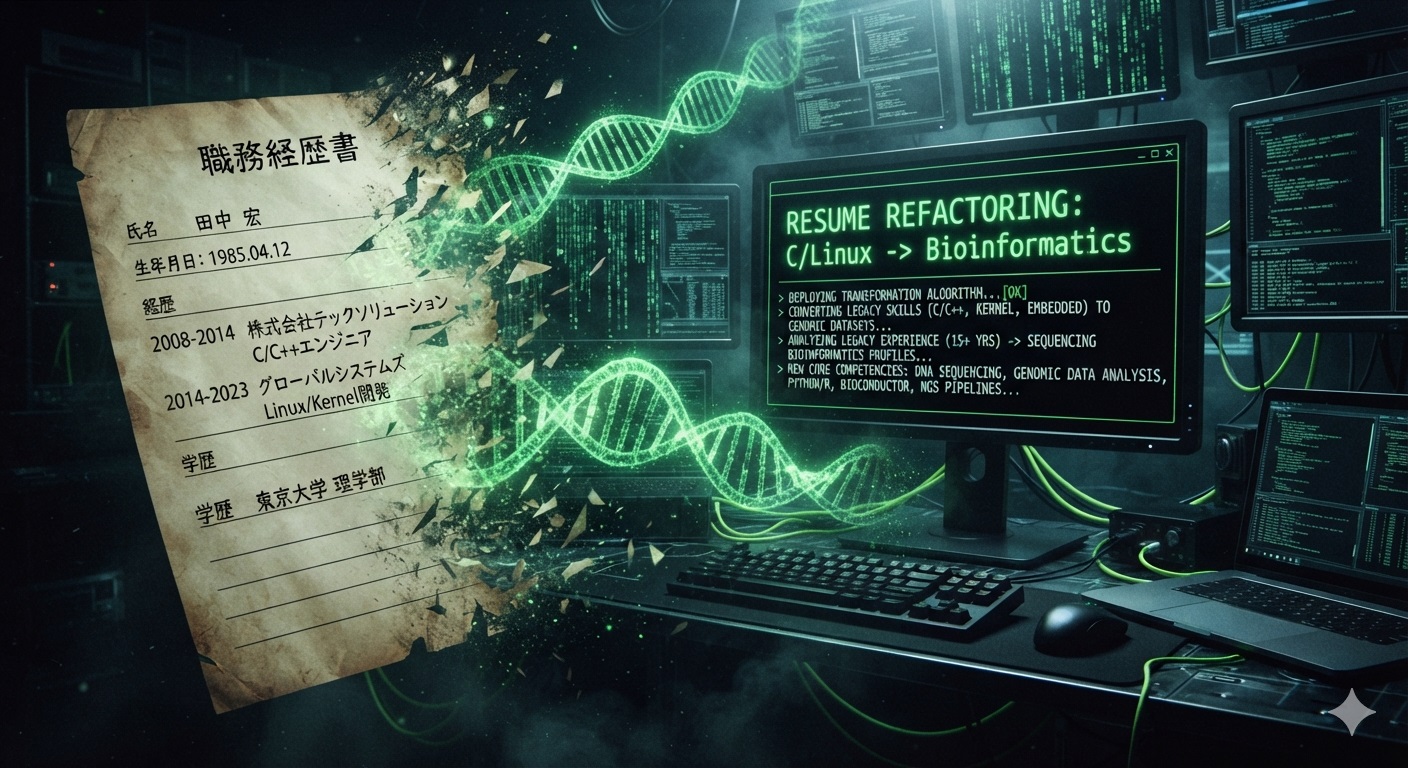
そこで今回は、私の職務経歴書(C言語、Linux、文字列処理)をバイオインフォマティクスの武器へと「リファクタリング(再構成)」し、大学院へ突きつける挑戦状の骨子を公開します。
■ 1. 【C言語とポインタ】 = ゲノムの「アドレス空間」を高速スキャンする
私のキャリアの核であるC言語では、メモリのアドレスを直接指定してデータを操作する「ポインタ」や「構造体」の深い理解が求められます。
人間の30億文字のゲノムDNAは、プログラマーから見ればまさに巨大な「メモリマップ」そのものです。
前々回の記事で考察した、テロメア(末端)やセントロメア(中央部)といった特定の制御用配列は、OSが参照する「制御用アドレス」に他なりません。
巨大なゲノム空間をシーク(探索)し、特定の配列を構造体として正確にマッピングするアルゴリズムにおいて、低レイヤーで培った「メモリ効率を極限まで高めた超高速処理」の思想はそのまま活きます。「マシンスペックとメモリを無駄遣いしない綺麗なコード」で、膨大なゲノムデータのパースを最適化します。
■ 2. 【Linuxとシェルスクリプト】 = テラバイト級の「ゲノムログ解析」を自動化する
長年、Linux環境で大規模システムのインフラ保守や、grep, sed, awk を駆使したテキスト処理、ログファイルの間引き、自動化パイプラインの構築を行ってきました。
次世代シーケンサー(DNA読み取り装置)から吐き出される生データは、テキストデータが詰まった「超巨大なログファイルの山」です。
がん細胞が安全装置のコードを勝手にコメントアウト(メチル化)している場所を特定する作業は、大規模システムのサーバーログから不正アクセスの痕跡(diff)を抽出するデータクレンジングと完全に一致します。
既存の解析ツール(NextflowやPythonライブラリなど)をただ動かすだけでなく、ボトルネックが発生した際には、C言語で「オレオレ高速フィルタリングツール」を自作して、データ解析のビルド時間を劇的に短縮する自信があります。
■ 3. 【分散処理とバッチ処理】 = 岡崎フラグメント型「並行データ解析」
これまでの開発では、巨大なデータを細切れにして並行して処理し、最後に1つに結合する「分散書き込み・非同期バッチ処理」の設計を数多く手がけてきました。
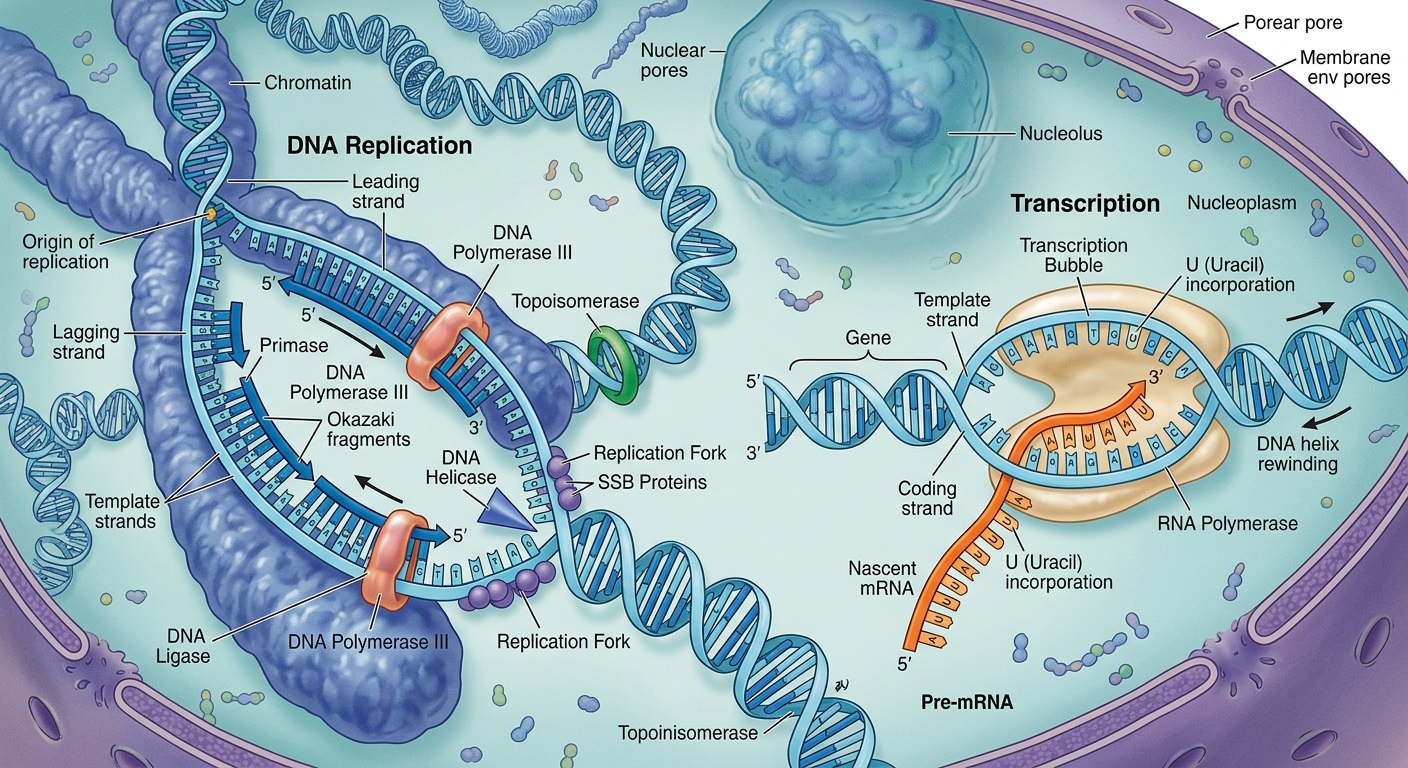
生命が逆向きのDNAを複製する際に行っている、データを100〜200文字ずつの細切れにして後から結合する「岡崎フラグメント」の思想は、まさに並行処理の極みです。
大学院のスーパーコンピュータ(スパコン)やクラウド環境のマルチコアを100%使い切り、巨大なゲノムデータを効率よく分散処理(MapReduce型のアプローチ)させるパイプライン設計において、私のバックグラウンドは強力な即戦力になります。
■ まとめ:私は「生命OSのデバッガー」として入学する
NAISTの教授陣に私が突きつける小論文の結論は、こうです。
「私は実験の戦力(ウェット)にはなれません。しかし、研究室に溜まっている『解析が追いつかないテラバイト級の巨大データ(ログ)』を、爆速でクレンジングしてバグ(変異)を抽出するスクリプトなら、誰よりも綺麗に書けます。私を、研究室の『生命OSのシニアデバッガー』として採用しませんか?」
これが、64歳の私がこれまでのレガシー資産を全投入して挑む、スキルコンバート型の挑戦状です。自分の強みをリファクタリングしてみたら、驚くほどバイオの世界と噛み合いました。
まずは9月の説明会で、この仕様書(熱意)を教授陣にデプロイしてきます!
それでは、また次回のビルドでお会いしましょう!