みなさん、こんにちは。64歳のプログラマーです。
前回は、がんゲノム解析が「30億文字のログから1文字のバグを探すデバッグ作業」であることをお話ししました。
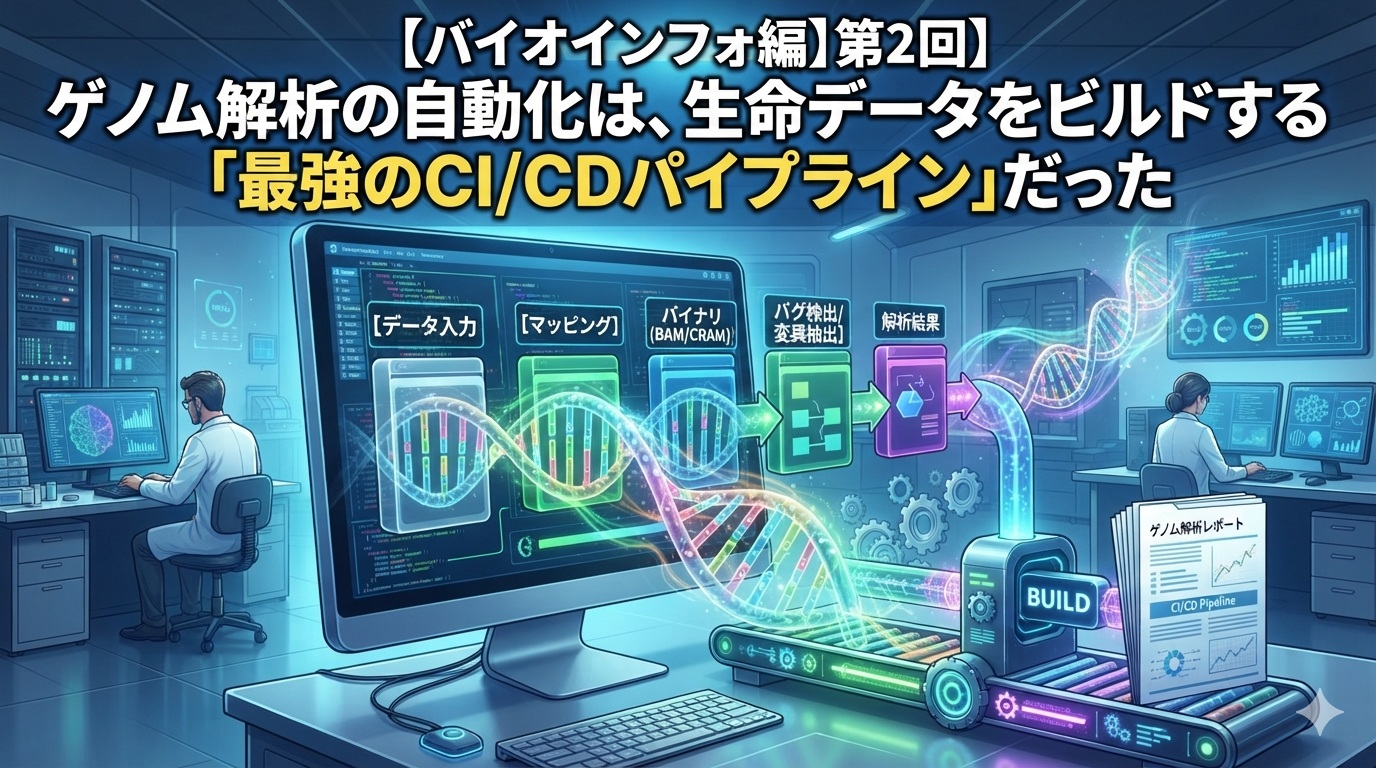
数GB〜数百GBの巨大なログファイルを、マッピングして、バイナリに変換して、バグを検出する――。これを毎回手動でコマンドを叩いていたら、日が暮れるどころか、コマンドの打ち間違い(オペレーションミス)で研究が崩壊してしまいます。
そこで登場するのが、バイオインフォマティクスの真骨頂「解析パイプラインの自動化」です。現場を覗いてみたら、そこはエンジニアにとってお馴染みの「CI/CD(継続的インテグレーション/継続的デリバリー)」の世界そのものでした。
🛠️ 1. Shellスクリプトの限界と、バイオ版「Make/Webpack」の登場
最初は誰もが、Linuxのコマンドを並べたシェルスクリプト(.sh)で自動化しようとします。しかし、ゲノム解析は途中でエラーが起きると悲惨です。
「10ステップある処理の8個目でコケた。修正して再実行したら、また1から数時間かけてやり直し…」
こんな絶望を解決するために、バイオの世界では Nextflow や Snakemake といった専用のワークフロー管理ツールが標準化されています。
- ITで言うと: ソースコードの依存関係を解決し、変更があったファイルだけを賢くコンパイルする
makeやCMake、あるいはフロントエンドのWebpack。 - バイオでは: 途中で処理が落ちても、そこまでのキャッシュ(中間ファイル)を保持し、「失敗したステップからピンポイントでレジューム(再開)」してくれる賢いビルドエンジン。
大規模なデータを扱うバイオの世界では、この「レジューム機能」がないとサーバーの電気代と時間がいくらあっても足りません。
📦 2. 「環境依存で動かない」を防ぐコンテナ技術
バイオインフォのツールは、学術コミュニティで開発された尖ったものが多く、「AというツールはPython 2.7でしか動かないが、BはPython 3.10が必要」「Cを入れたらライブラリのバージョンが衝突して全滅した」といった、いわゆる「依存関係地獄(Dependency Hell)」が日常茶飯事です。
これらを解決するため、現代のゲノム解析パイプラインは完全にコンテナ化されています。
- ITで言うと: 「俺の環境では動いたんだけどな」を撲滅する
DockerやKubernetes。 - バイオでは: Biocontainers という巨大なレジストリがあり、数千種類以上のバイオツールが最初からDocker/Singularityイメージとしてパッケージ化されています。
これらをNextflowなどのスクリプト内で「このステップは、このDockerイメージで動かす」と1行書くだけで、自動でコンテナが立ち上がり、解析が終わると消えるスマートな設計になっています。
☁️ 3. スパコンやクラウドへの「サーバーレス・デプロイ」
個人のがんゲノム解析ならPCでもなんとかなりますが、何百人もの患者さんのデータを一気に処理する場合、ローカルマシンではスペック不足で火を吹きます。
モダンなバイオパイプラインツールは、コードを1行も書き換えることなく、実行環境(Executor)を切り替えることができます。
- ITで言うと: ローカルでのテスト環境から、AWS LambdaやECS、あるいはオンプレミスのHPC(高性能計算クラスタ)へ設定一つでスケールアウト。
- バイオでは: 設定ファイル(
nextflow.config)の1行をlocalからawsbatchやslurm(スパコンのジョブ管理システム)に変えるだけ。
コードはそのままで、数千個のゲノムデータをクラウド上の数千台の仮想マシンへ分散させて並列処理させる――。インフラエンジニアが見たら大興奮間違いなしの、美しいオーケストレーションが実現されているのです。
🚀 今回のハックまとめ
遺伝子の解析現場は、最新のソフトウェア工学の塊でした。
「Nextflow(CI/CD) + Biocontainers(Docker) + クラウド/スパコン(インフラ自動スケール)」。
この3種の神器によって、世界中の研究者が「誰がどこで実行しても、全く同じ解析結果(再現性)」を担保しています。開発環境のポータビリティや再現性に血を吐いてきたベテランエンジニアほど、このシステムの美しさに感動するはずです。
次回は、いよいよこれらを使って集めたデータから「AI・機械学習」を使ってがんの本質に迫る、データサイエンス編をお届けします。お楽しみに!