みなさん、こんにちは。64歳のプログラマーです。
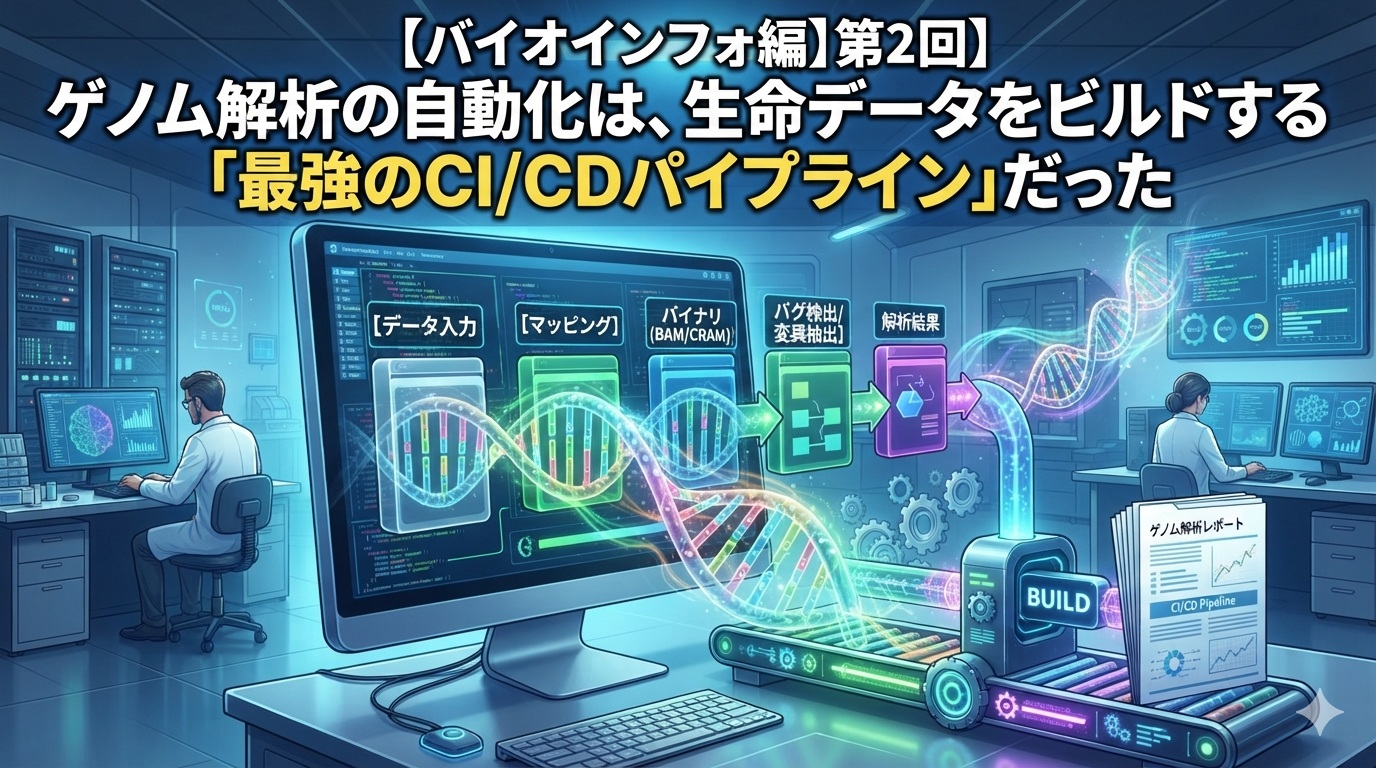
第1回ではゲノムのデバッグ(変異検出)を、第2回ではそれを自動化する最強のCI/CDパイプライン(Nextflow)をご紹介してきました。
最終回となる今回は、集まった膨大なデータから「未来を予測する」、AI・機械学習(データサイエンス)の世界へ足を踏み入れます。
結論から言うと、現代のバイオロジーは、完全に「超高次元データの機械学習コンペ」状態になっていました。
📊 1. 細胞のステータスは「数万次元の巨大マトリクス」
人間の細胞には、約2万種類もの遺伝子が存在します。
第2回のパイプラインによって処理されたデータは、最終的に「どの細胞で、どの遺伝子が、どれくらい働いているか(発現量)」が数値化された、巨大な行列(マトリクス)として出力されます。
- ITで言うと: 特徴量(カラム数)が「2万個」もある、超高次元のテーブルデータ。
- バイオでは: 1つの細胞、あるいは1人の患者さんごとに2万次元のベクトルデータが存在する状態。
データサイエンティストなら、この時点で「前処理や次元削減(PCAやt-SNE)のやり甲斐がありすぎる!」と血が騒ぐはずです。
🤖 2. がんの予測モデル = 「不正アクセス検知システム」
この2万次元のデータを機械学習(scikit-learnなど)に放り込むことで、「この発現パターンの患者さんは、将来がんが再発するか?」「どの薬が効くか?」を予測するモデルを作ることができます。
このアプローチは、私たちがWeb開発でよくやるシステムと本質的に同じです。
- ITで言うと: 過去の膨大なアクセスログ(特徴量)から、サイバー攻撃やクレカの不正利用の兆候を検知する分類モデル。
- バイオでは: 2万個の遺伝子の動き(特徴量)から、細胞が「がん化」へ暴走する兆候を検知する分類モデル。
ただし、バイオデータは「サンプル数(患者数)に比べて、特徴量(遺伝子数)が圧倒的に多い」という特徴があります。そのため、普通にモデルを組むと一瞬で過学習(オーバーフィッティング)を起こします。いかにして重要な遺伝子を絞り込むか(特徴量選択)という、データサイエンティストの腕の見せ所がここにあります。
🧬 3. AlphaFold = 「究極の構造解析・レンダリングエンジン」
そして、バイオ×AIの歴史を完全に塗り替えたのが、Google DeepMind社が開発した「AlphaFold」です。
アミノ酸の配列(文字列)を入力するだけで、それが3次元空間でどう折りたたまれてどんな立体構造(タンパク質)になるかを、AIが超高精度で予測してしまいます。
- ITで言うと: 設計図(テキスト)を渡すだけで、物理演算をすべて計算し尽くし、完璧な3Dモデルを自動生成する神がかったレンダリングエンジン。
- バイオでは: これまで世界の天才科学者が何ヶ月も(時には何年も)かけて実験で突き止めていたタンパク質の立体構造を、AIがわずか数分で予測するパラダイムシフト。
この立体構造が分かれば、「がん細胞のこのポケット(隙間)にぴったりハマる鍵(新薬の分子)」を、PC上のシミュレーションでデザインできるようになります。創薬のプロセスが、完全に「ソフトウェア開発」へとシフトしているのです。
🚀 【バイオインフォ編】総括:生命科学は、プログラマーのフロンティアだ
全3回にわたって、未履修から突っ込んだバイオ・がん研究の世界をプログラマー目線でハックしてきました。
- DNAは「生命のソースコード」
- 解析は「CI/CDパイプラインとコンテナ」
- 未来の予測は「AIとデータサイエンス」
バイオロジーを学ぶ中で私が確信したのは、「これまでITの世界で培われてきたエンジニアリングの知恵(設計思想、自動化、データ処理)は、そのまま生命の謎を解き明かす最強の武器になる」ということです。
生命という、地球上でもっとも洗練された「レガシーシステム」のデバッグ。これほどエンジニアとしてエキサイティングな挑戦は他にありません。
みなさんも、プログラミングの知識を片手に、バイオの世界を覗いてみませんか?
(連載・バイオインフォ編 完)