みなさん、こんにちは。64歳のプログラマーです。
前回、がん研究の夢を叶えるためにPythonの勉強を始めたとお話ししました。今回は、ゲノム解析の現場で実際に使われている「生のデータ」について調べて驚いたことを共有します。
がん研究のデータというと、何か特殊な暗号ファイルのようなものを想像していましたが、その正体は意外なほどシンプルで、かつ圧倒されるものでした。
1. ゲノムデータの正体は「巨大なテキストファイル」
私たちが病院や研究室でDNAを解読する装置(シーケンサー)を使うと、最初に「FASTQ(ファストキュー)」という形式のファイルが出力されます。
この中身を恐る恐る覗いてみると、なんとただの「テキストファイル(文字の並び)」でした。メモ帳やLinuxのコマンドでそのまま開けてしまうのです。
ファイルを開くと、次のような4行セットのデータが、延々と、それこそ何千万、何億行も並んでいます。
@ERR123456 (データの名前・ID)
GATTACA... (A、T、C、Gの塩基配列)
+ (区切り線)
IIII9IG9... (読み取りの正確さを表す品質スコア)
遺伝子の情報とは、本当に「A(アデニン)、T(チミン)、C(シトシン)、G(グアニン)」という4つの文字の羅列なんだ、と画面の前で深く感動してしまいました。
2. C言語プログラマーの血が騒ぐ「狂気のファイルサイズ」
しかし、感動したのも束の間、そのファイルサイズを知って職業病(C言語プログラマーの血)が騒ぎ始めました。
なんと、1人分の全ゲノムデータは数十〜数百ギガバイト(GB)に達することもあるそうです。
C言語でプログラムを書く人間にとって、ギガバイト単位のテキストファイルを扱うというのは「恐怖」でしかありません。
- 「これ、うっかりExcelで開いたら確実にパソコンがフリーズするな……」
- 「通常の配列(Array)に一気に読み込もうとしたら、メモリ(RAM)が一瞬でパンクするぞ」
- 「C言語なら、ファイルを少しずつ読み込む(ストリーム処理)ポインタ計算をガチガチに組まないと破綻する……!」
そんな不安が頭をよぎりました。
3. だからこそ、PythonとITの力が必要なんだ
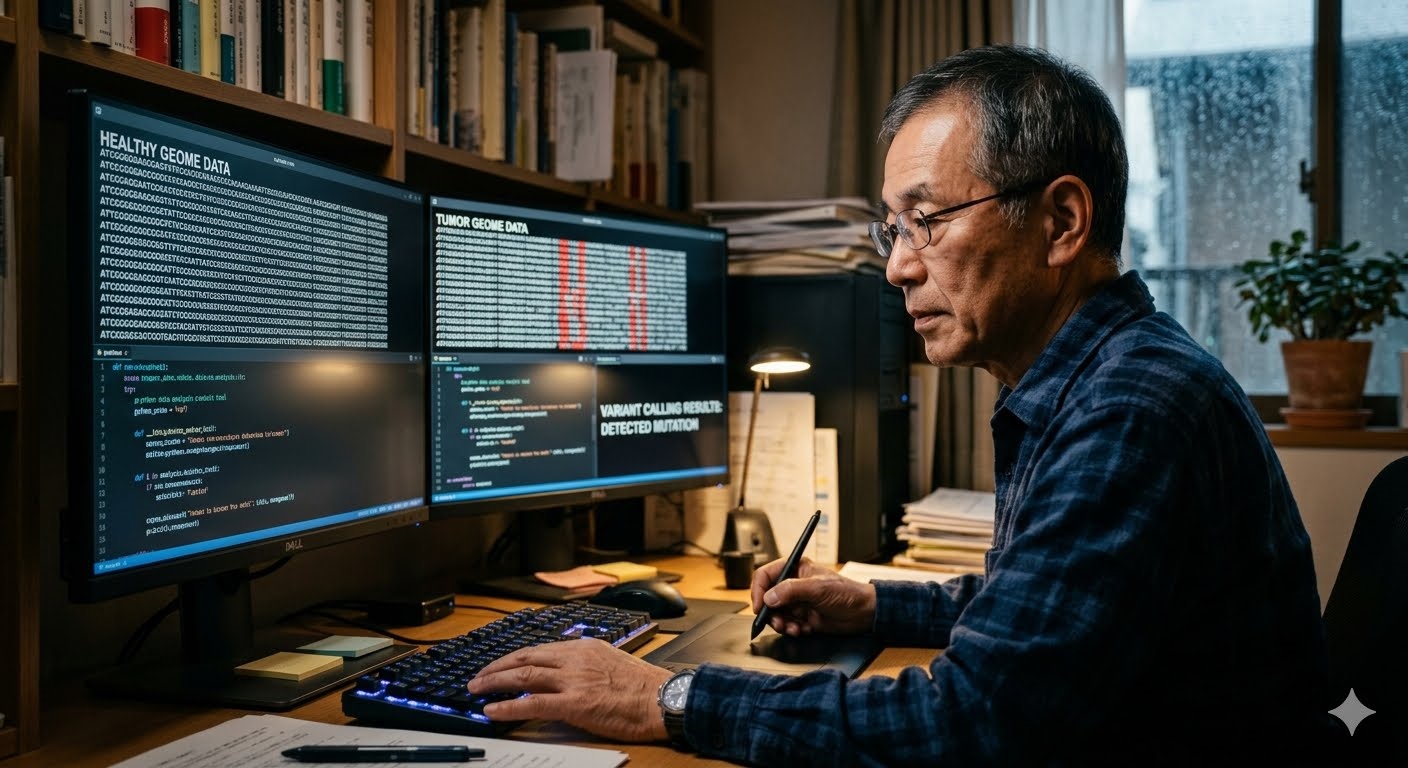
バイオの世界では、この「巨大すぎる4文字のテキストファイル」を何百人、何千人分も比較して、がんの原因となる「文字の打ち間違い(変異)」を探し出します。
人間の手で読めるわけがありませんし、C言語でゼロから解析ツールを作るのも、メモリ管理のバグとの戦いになり、気が遠くなります。
そこで活躍するのがPythonです。
Pythonには、この数億行のテキストデータを効率よく読み込み、高速で検索や並び替えをしてくれる「バイオ解析専用の部品(ライブラリ)」がたくさん用意されていることが分かりました。
「なるほど、だから最先端のがん研究にはITの力が必要と言われるのか」と、バラバラだったパズルのピースが繋がったような気がします。
道具は揃った、いよいよ解析へ
これまでは顕微鏡の世界だと思っていた「がん研究」が、データサイズとの戦いという「プログラマーにお馴染みの世界」に見えてきたことで、少し自信が湧いてきました。
次回は、この巨大な「A、T、C、G」のデータから、どうやってがんの遺伝子を見つけ出すのか、その仕組みについて学んだことを書いてみたいと思います。
一歩ずつ、でも確実に、64歳の挑戦は続いていきます!
コメント