みなさん、こんにちは。64歳のプログラマーです。
前回、ゲノム解析の生データは、数億行にも及ぶ「A、T、C、G」の巨大なテキストファイル(FASTQ形式)だとお話ししました。
今回は、この途方もない文字の羅列から、どうやって「がんの原因」を見つけ出すのか。その仕組みを調べていくうちに、私の中に「ある強烈な既視感」が湧いたお話です。
結論から言うと、がん研究のデータ解析は、私たちが普段やっている「プログラムのデバッグ」や「コードの差分比較(diff)」と全く同じでした。
1. まずは「マスターコード」に並べる(マッピング)
バラバラに解読された数億行の文字データは、そのままではどこが何を表しているのか分かりません。
そこで最初に行うのが、人間の遺伝子の設計図の基準である「リファレンス配列(標準ゲノム)」に、自分のデータをペタペタと並べていく作業です。
これをプログラミングに例えるなら、「正常に動いている本番環境のソースコード」を横に広げ、自分の手元にあるコードを一行ずつ綺麗に並び替えて、見比べられる状態にするイメージです。
2. 正常なコードと、がんのコードの「diff」を取る
並び替えが終わったら、いよいよ本番です。
がんを見つけるための基本は、驚くほどシンプルでした。
- 「健康な細胞のデータ」
- 「がん化した細胞のデータ」
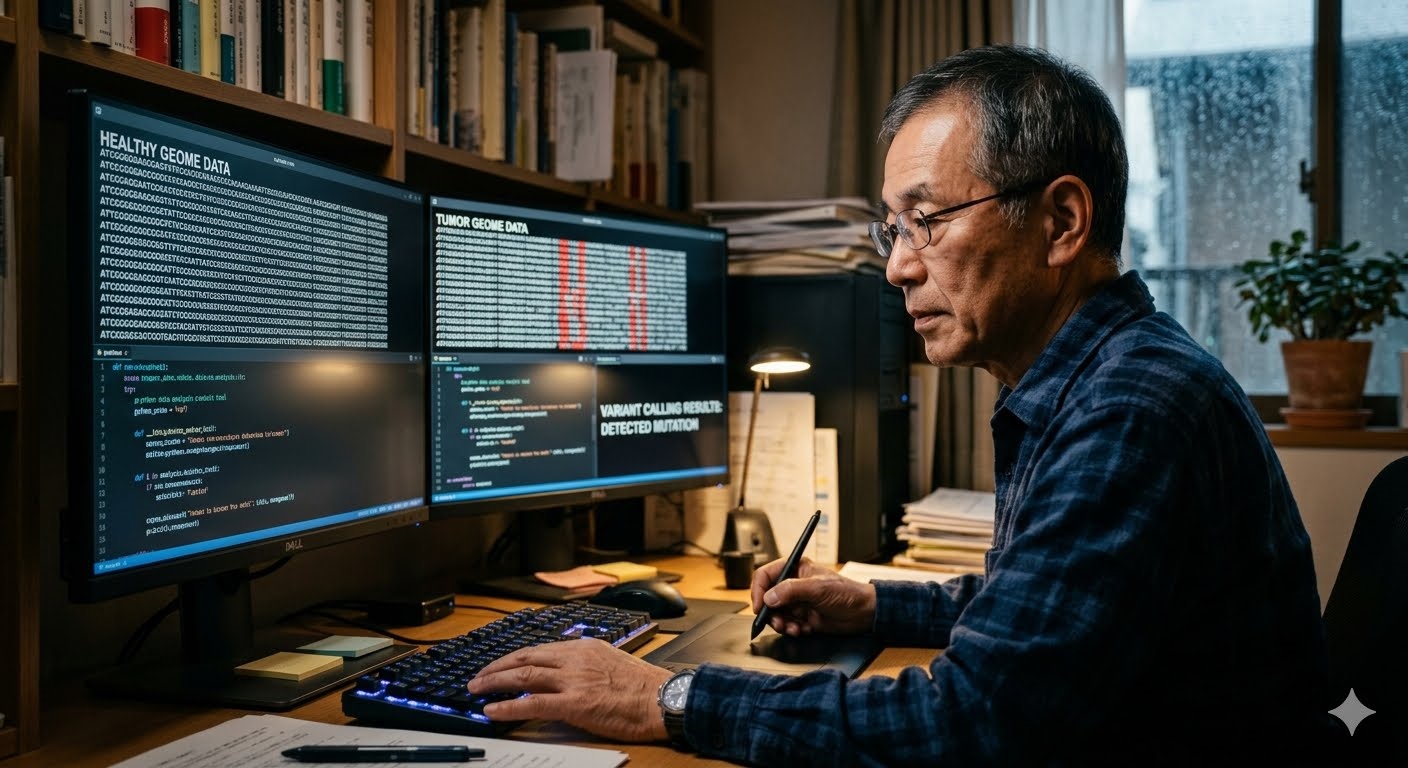
この2つのテキストファイルを並べて、「どこが書き換わっているか」の差分(diff)を取るのです。
数万行のソースコードからバグを探すとき、私たちはよく「diffコマンド」を使って、変更された行(赤い行と青い行)を浮き彫りにしますよね。ゲノム解析でも、全く同じように「正常な配列」と「がんの配列」を比較して、1文字だけ違う部分(変異)をシステムが自動で検出します。
バイオの世界では、この差分を検出する作業を「バリアントコール」と呼ぶそうです。
3. 1文字の打ち間違いが、大バグ(がん)を引き起こす
プログラムでも、たった1文字「;(セミコロン)」を打ち間違えたり、= を == と書き間違えたりするだけで、システム全体が大暴走することがあります。
人間の身体も全く同じでした。
30億文字ある遺伝子情報のうち、たった1文字「A」が「T」に変わってしまっただけで、細胞を増殖させるスイッチが壊れ、制御不能になって暴走を始めてしまう。これが「がん」の正体の一つです。
「そうか、がん治療の研究とは、この1文字のバグ(変異)が、身体というシステムのどこに影響を与えているかを突き止める作業なんだ」
そう理解した瞬間、一見遠い世界に見えた医学の世界が、一気に自分のプログラマーとしての経験と地続きになった気がしました。
デバッガーとしての新しい一歩
C言語のポインタのバグで画面をフリーズさせていた私が、今度は「人類のバグ(がん)」を見つけるデバッガーになろうとしている。そう考えると、なんだか胸が熱くなります。
Pythonには、この「差分(変異)を見つける」ための強力なライブラリが揃っています。次回は、実際にPythonのコードを動かして、簡単なデータ処理に挑戦した様子をお届けしたいと思います。
64歳のデバッガーの挑戦、まだまだここからです!
コメント