みなさん、こんにちは。64歳のプログラマーです。
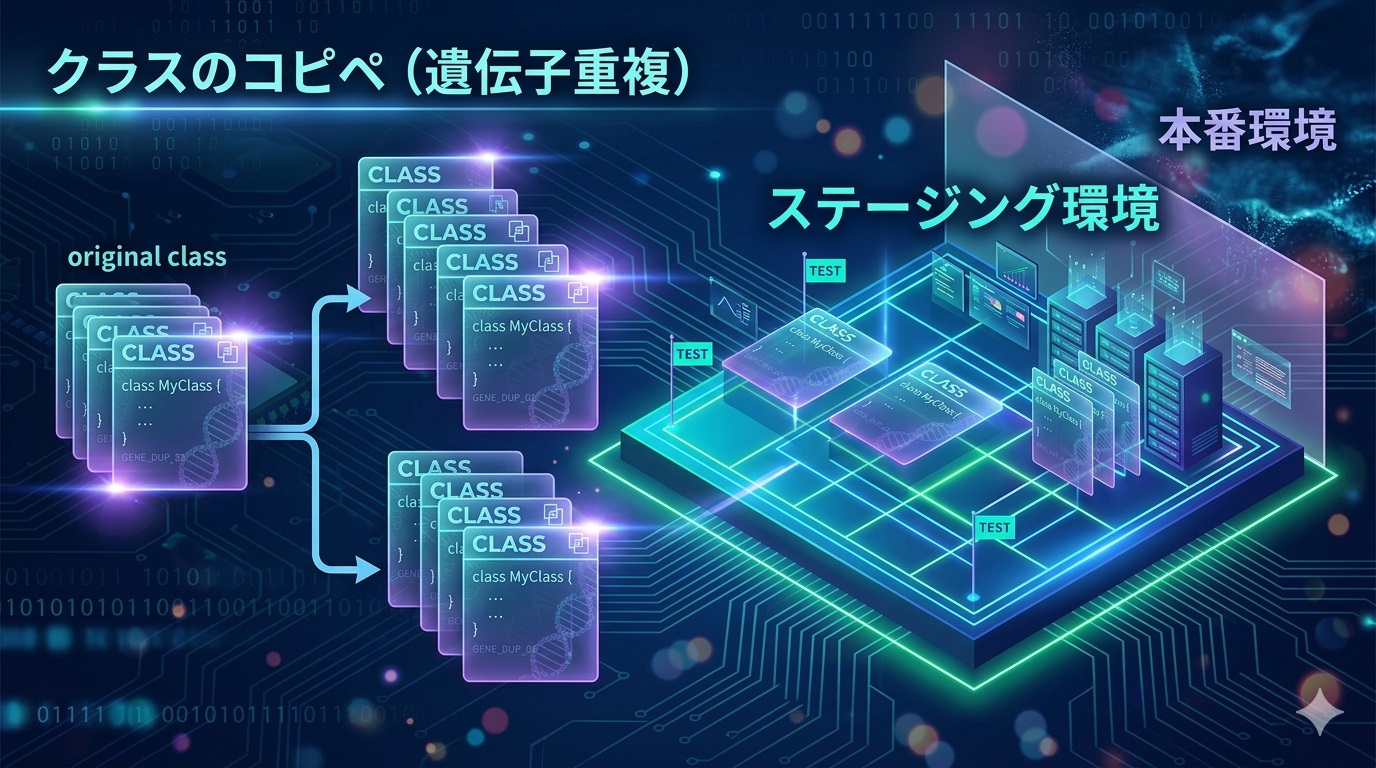
前回は、遺伝子重複を「クラスのコピペによる安全な機能拡張」に例えて解説しました。
第9章ハックの最終回となる今回は、異なる生物のゲノム配列を比較する技術を、エンジニアにお馴染みのソースコード差分チェック(git diffコマンド)に例えてデバッグします。
30億文字のソースコードを並べて見えてきた、生命というシステムの壮大な設計思想に迫ります。
1. ゲノムアライメントは「大規模なコードのgit diff」
バイオインフォマティクス(生物情報科学)の世界では、ヒトやチンパンジー、さらにはマウスや細菌のゲノム配列(DNAの文字列)を横一列に並べて比較する「ゲノムアライメント」という技術があります。
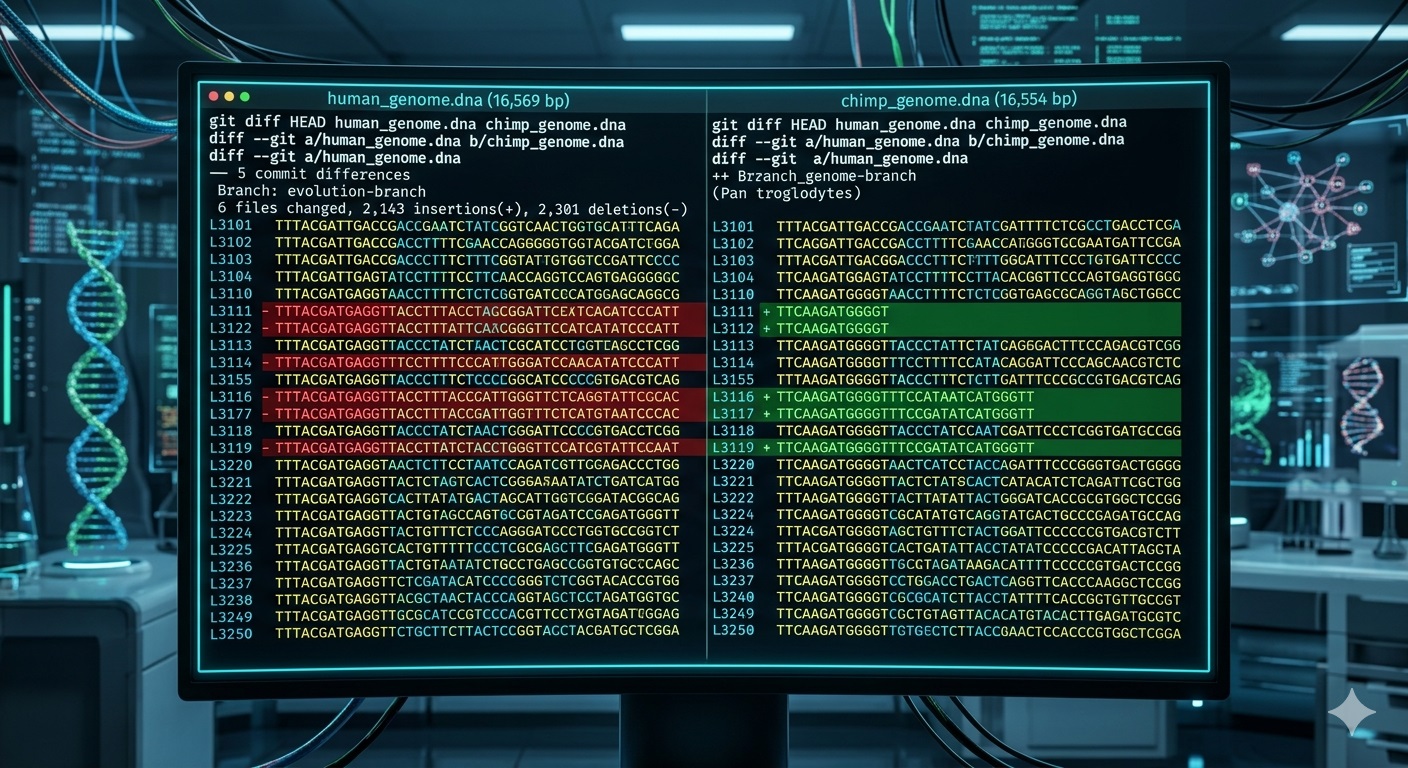
これはプログラマーの目から見れば、2つの異なるリポジトリを突合して、どこが書き換わったかを調べる「git diff human_v1.0 chimpanzee_v1.0」そのものです。
- 追加されたコード(グリーン):新しい種になって追加された機能。
- 削除されたコード(レッド):退化した機能、あるいは不要になったレガシーコード。
- 一致しているコード(ホワイト):祖先からそのまま引き継がれたロジック。
この差分(diff)を詳細に解析することで、「どのコミット(変異)が原因で、ヒトは独自の知能や身体をビルドできるようになったのか」を突き止めることができます。
2. 「高度に保存された領域」は、生命OSのカーネル(コアシステム)
興味深いことに、数億年前に分岐したヒトとマウスのコードを「git diff」しても、何億年もの間、1文字も書き換えられていない「完全に一致する領域」がいくつも見つかります。教科書ではこれを「高度に保存された領域」と呼びます。
プログラムで言えば、これはOSの最深部である「カーネル(Linuxなどのコアシステム)」や、絶対に書き換えてはいけない「暗号化ライブラリ」のようなものです。
- リボソーム(翻訳の実行エンジン)の基幹ロジック
- 細胞分裂の基本アルゴリズム
これらの超重要関数は、数億年の歴史の中で1文字でもタイポ(突然変異)が入ると、システム全体が即座にクラッシュ(死)するため、自然淘汰の鉄槌によって一切の変更が拒絶されてきました。つまり、バグが出尽くした完璧な枯れたコードとして、すべての地球生物に共通して使われ続けているのです。
3. ドライ解析の本質は「コードの変更履歴(git log)の読解」
30億文字もの巨大なゲノムデータから、この「変わったコード(差分)」と「変わらないコード(カーネル)」をコンピュータで検出し、がんの原因や生命の謎を解き明かすこと。これこそが、私が大学院で学びたい「ドライ解析」の本質です。
数億年分の「生命のコミットログ(git log)」をPythonやC言語のデータ解析スキルで読み解いていく作業は、ベテランエンジニアとしての知的好奇心をこれ以上ないほど刺激してくれます。
デバッグ完了:第9章を終えて
第9章ハックの3連載を通じて、突然変異(野良コミット)、遺伝子重複(コピペ拡張)、そしてゲノム比較(git diff)までをプログラマーの視点でデバッグしてきました。
さて、気がつけば8月も中旬。9月のNAIST受験本番がすぐそこに迫ってきました。
教科書のハックはいったんここで区切り、次回はリアルな受験対策の進捗、特に試験官(レビュー担当者)を唸らせるための「研究計画書のリファクタリング」の修羅場についてお届けしようと思います!
次回のリアルタイムドキュメントもお楽しみに!