みなさん、こんにちは。64歳のプログラマーです。
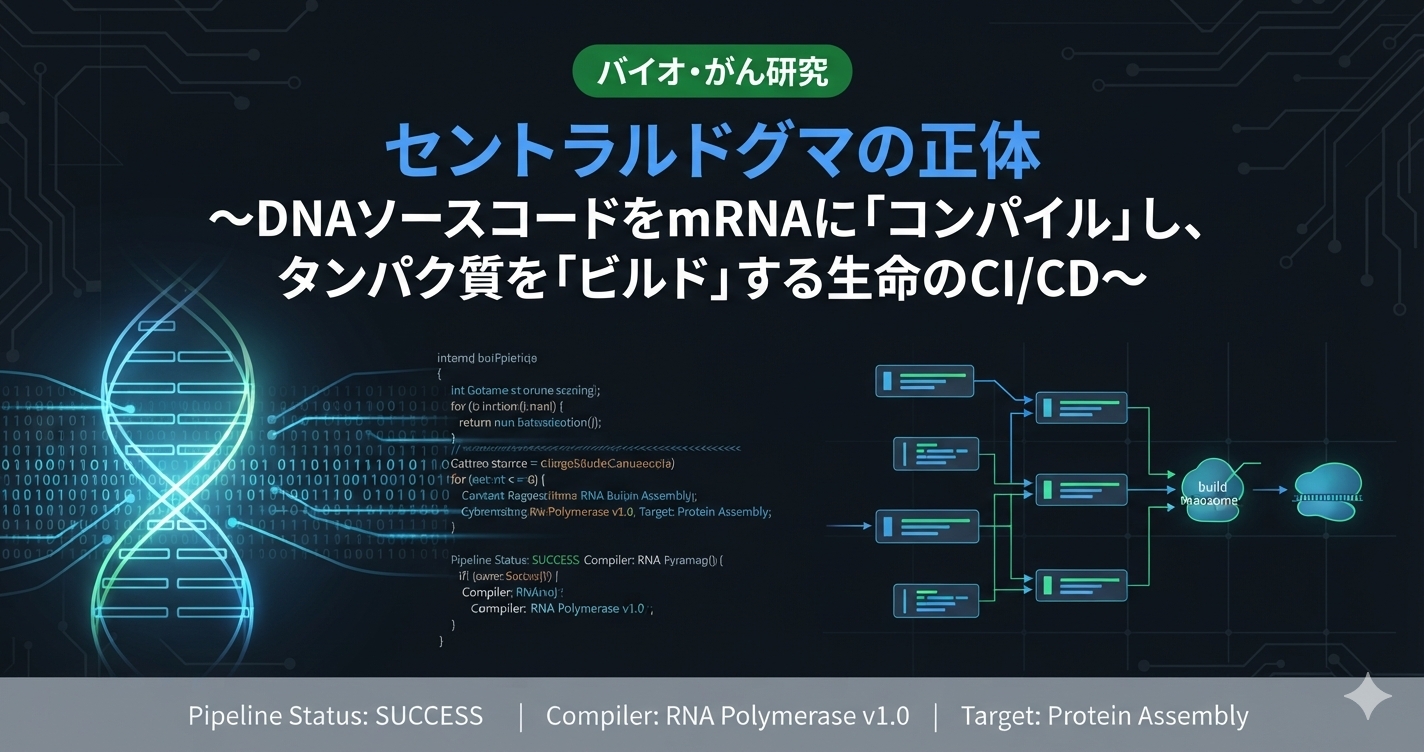
C言語の世界でコードを書いているとき、私たちはソースコード(.c)をコンパイルしてオブジェクトファイル(.o)を作り、最終的にリンカを通して実行ファイル(バイナリ)をビルドしますよね。この一連のパイプライン、実は私たちの細胞の中でも、まったく同じことが37兆個のコンテナ(細胞)で毎秒実行されているのをご存知でしょうか。
分子生物学の超基本原理であり、最大の根幹である**「セントラルドグマ(Central Dogma)」**。
医科学の教科書を開いたとき、私は思わず膝を打ちました。「なんだ、これは生命OSの自動ビルドシステム(CI/CD環境)そのものではないか」と。今回は、未履修のプログラマー視点で、この神秘的なビルドパイプラインをデバッグしてみたいと思います。
1. DNA:絶対に汚してはならない「本番環境のマスターソースコード」
まず、すべての設計図が格納されている**「DNA」**です。
プログラマ的な視点で見ると、DNAはストレージ(核内)の奥深くに格納された、読み取り専用(Read-Only)の**「Gitのmainブランチ(マスターソースコード)」**です。データ構造としては、A(アデニン)、T(チミン)、G(グアニン)、C(シトシン)という4つの文字で記述された、4進数の超巨大なソースコードファイル群と言えます。
本番環境のソースコードは、絶対に直接書き換えてはいけませんし、むやみに実行環境へ露出させてもいけません。紛失や破損(デッドロックやデータ壊れ)のリスクがあるからです。
そのため、細胞というシステムは、このマスターソースコードを「核」という厳重なディレクトリの中に隔離し、アクセス権限を制限しています。
2. 転写(Transcription):必要な機能だけをメモリに展開する「コンパイル」
では、システムが特定の機能(タンパク質)を必要としたとき、どうするのか。必要な部分のソースコードだけを別ファイルに書き出します。これが**「転写(Transcription)」**です。
開発環境で例えるなら、膨大なプロジェクトから今必要な .c ファイルだけをピックアップし、中間コード(あるいは一時バッファ)に**コンパイル(エクスポート)**する処理です。
このとき活躍するのが「RNAポリメラーゼ」というコンパイラツールです。DNAの二重らせんをほどき、必要な遺伝子領域(ソースの特定行)だけを高速でスキャンして、1本鎖の**「mRNA(メッセンジャーRNA)」**という中間コードを生成します。
C言語風の擬似コードで表すなら、核内で行われている処理はこんなイメージです。
// 核内(Repository)での転写処理イメージ
mRNA_t* transcription(const DNA_t* main_branch, const char* gene_id) {
    // 必要な遺伝子領域(アドレス)を検索
    DNA_Region_t* target = src_search(main_branch, gene_id);

    // 一時的なバッファ(mRNA)にソースコードをコピー(TはUに置換される仕様)
    mRNA_t* mrna_buffer = copy_to_mrna(target);

    return mrna_buffer; // 核外(実行環境)へエクスポート
}
このmRNAという「一時ファイル」が作られるおかげで、マスターソース(DNA)を安全に保ったまま、次のビルド工程へ進むことができるわけです。
3. 翻訳(Translation):リボソームというビルドマシンでの「バイナリ生成」
核内で作られたmRNAは、核膜のポートを通過して「細胞質」という名の実行環境へデプロイされます。ここで待っているのが、生命の高性能ビルドマシン**「リボソーム」**です。
リボソームが行う処理、それこそが**「翻訳(Translation)」。すなわち、中間コード(mRNA)を読み込み、実際の構造体である「タンパク質(実行可能バイナリ)」**へとビルドする工程です。
ここで驚くべきは、データのデコード仕様です。
mRNA上の塩基は、3文字で1つのセット(コドン)として扱われます。4進数のデータが3桁並ぶので、4の3乗で**「64通り(6ビット分)」**の組み合わせが存在します。
この64通りのコードが、体に不可欠な「20種類のアミノ酸」のいずれかにマッピングされるのです。リボソームの内部では、まさに以下のような巨大な switch-case 文によるデコードが超高速で回っています。
// リボソーム(Build Machine)内でのデコード処理イメージ
AminoAcid_t decode_codon(const char codon[3]) {
    // 3文字の塩基コードをアミノ酸IDへマッピング(4進数3桁のデコード)
    switch(get_codon_hash(codon)) {
        case HASH_AUG: return METHIORINE; // 開始コドン(main関数のエントリーポイント)
        case HASH_UUU: return PHENYLALANINE;
        case HASH_GGU: return GLYCINE;

        case HASH_UAA:
        case HASH_UAG:
        case HASH_UGA: return STOP_SIGNAL; // 終止コドン(return 0;)

        default: return UNKNOWN_ERROR;
    }
}「開始コドン(AUG)」というエントリーポイントから読み込みが始まり、リボソームはmRNAのテープを1コマずつ進めながらアミノ酸を連結(ポインタ結合)していきます。そして「終止コドン」を検知すると、ビルドを終了(return 0;)します。
こうして数珠繋ぎになったアミノ酸チェーンが、固有の立体構造に折りたたまれる(リファクタリングされる)ことで、ようやくシステムを動かす実体=「タンパク質バイナリ」が完成します。
4. おわりに:がん研究は、このビルドパイプラインのデバッグ
DNA(ソースコード) ➡️ mRNA(中間コード) ➡️ タンパク質(バイナリ)。
この一方向へのデータ流量制御こそが、生命OSを駆動する中央集権的な基本原則、セントラルドグマです。
プログラマーが毎日のように開発環境で行っている「コードを書いて、ビルドして、実行ファイルを動かす」という一連のCI/CDパイプラインを、私たちの細胞は気が遠くなるほどの精度と速度で、今この瞬間も繰り返しています。
しかし、どんなに優れた自動ビルドシステムにも、時にバグは混入します。
DNAのソースコードに予期せぬ書き換え(遺伝子変異)が発生したり、コンパイルや翻訳の段階で制御ループが暴走したりする。その結果として生まれてしまう「不正な仕様の異常バイナリ(がんタンパク質)」が、システム全体をクラッシュさせていく――。
がん研究の実験室を目指すということは、この精緻極まる生命のビルドパイプラインを観察し、どこでバグが紛れ込んだのかを突き止める「デバッガー」になることなのだと、64歳にして改めてワクワクしています。
今日も一歩、生命OSのソースコード解読へ。未履修からの挑戦は続きます。