みなさん、こんにちは。64歳のプログラマーです。
前回までで、DNAという「マスターデータ」を完璧に複製・修復する保守管理(第6章)の話を終え、いよいよ第7章「転写と翻訳」へと突入しました。
どれほど厳重に守り抜いたソースコード(DNA)も、実際に実行してアプリケーション(タンパク質)にビルドしなければシステムとして意味をなしません。しかし、生命のシステムは、マスターリポジトリから直接コードを実行するような危険な真似はしません。
核内という「安全な開発環境」でコードをコピーし、無駄を徹底的に削ぎ落としてから細胞質(本番環境)へデプロイする。その極めて洗練されたビルドプロセスをデバッグ(考察)します。
■ 転写 = マスター保護のための「ソースコードのエクスポート」
なぜ細胞はDNAを直接使わず、わざわざ「RNAポリメラーゼ」という酵素を使って、シングルスレッドの「mRNA(伝令RNA)」に書き写す(転写する)のでしょうか?
プログラミングの視点で見ると、DNAは絶対に書き換えられてはならない、読み取り専用の「マスターリポジトリ(本番データベース)」です。
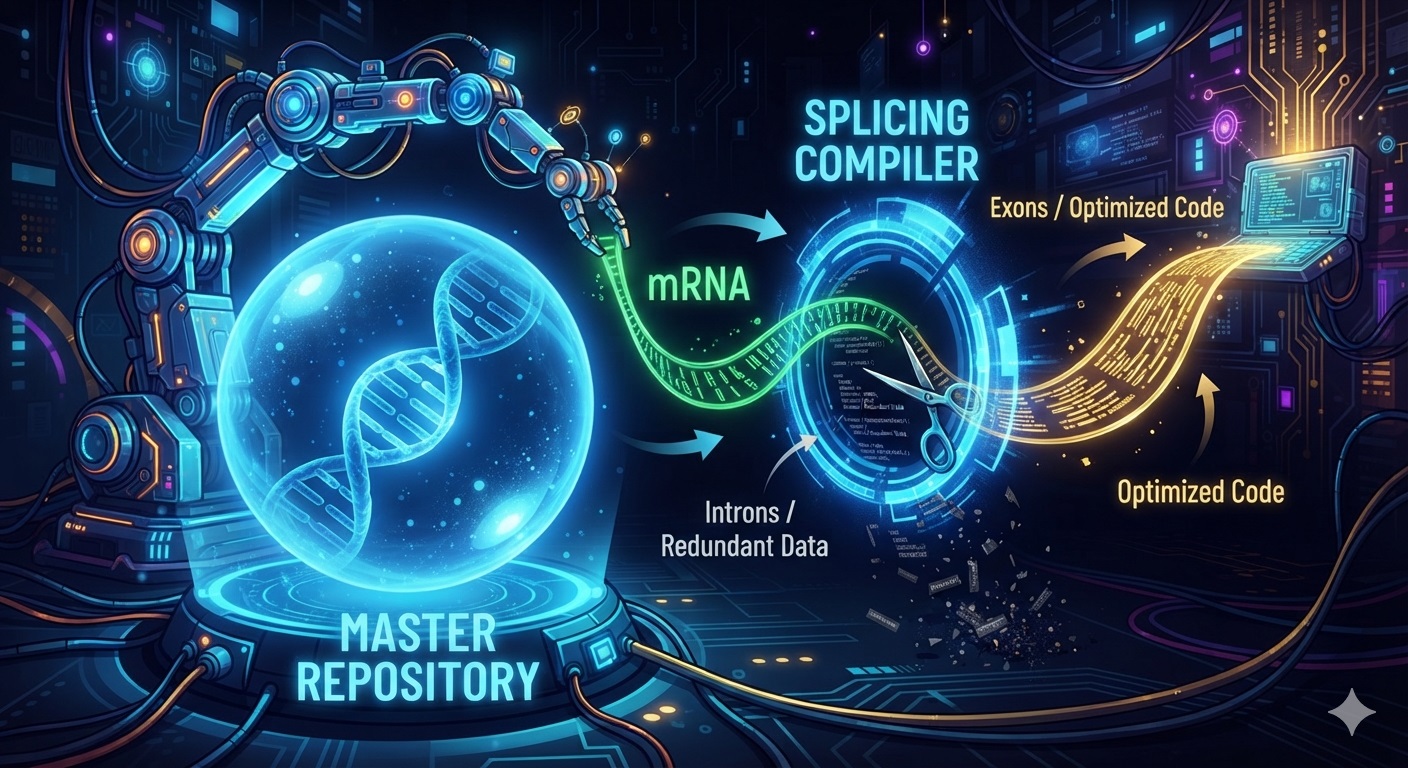
そこから「今実行したい特定の機能(遺伝子)」だけを、作業用のテンポラリファイル(mRNA)として「エクスポート(フォーク)」しているのです。
もし書き出し中にパケットロスやエラーが起きても、使い捨てのmRNAが壊れるだけで、マスターデータ(DNA)は無傷で済みます。生命の徹底したデータセキュリティ設計には、インフラエンジニアとしても脱帽するしかありません。
■ RNAスプライシング = 無駄を削るビルド処理「デッドコード削除」
こうして写し取られたばかりの生データ(プレmRNA)ですが、実はそのままでは実行できません。コードの中に、タンパク質に翻訳されない「イントロン」という無駄な文字列が含まれているからです。
これを「スプライソソーム」という巨大な分子マシンが精密に切り捨て、本当に必要なコード領域「エキソン」だけを綺麗に繋ぎ合わせます。
これは、開発中に残してしまった不要な関数やデバッグ用のログを、本番ビルド時に自動で削ぎ落とす「デッドコードの削除(Tree Shaking)」そのものです。
本番環境のメモリ(細胞質)を圧迫しないよう、徹底的に軽量化した「最適化バイナリ」を出力する。生命は数億年前からこのビルド最適化を自動で行っていたわけです。
■ 選択的スプライシング = 究極の「クロスコンパイル」
さらに興奮するのが「選択的スプライシング」という仕組みです。
イントロンを切り捨てる際、必要なコード(エキソン)の組み合わせを動的に変えることで、たった1つの遺伝子から、全く異なる性質のタンパク質を複数作り出すことができます。
これこそ、1つの共通ソースコードから、コンパイルスイッチの切り替えだけで「Windows版」「Mac版」「Linux版」の実行ファイルを生成し分ける「クロスコンパイル」の思想そのものです。
ゲノムの容量(ストレージ)を最小限に節約しつつ、システムの表現力を最大化する。生命のコード再利用アルゴリズムの美しさには、ただただシびれるばかりです。
■ まとめ:生命のビルドプロセスは美しかった
DNAからRNAへの移行とスプライシングは、単なるマニュアルの書き写しではなく、本番環境へ安全かつ軽量にデプロイするための「高度なビルド・最適化プロセス」でした。
C言語のコンパイルオプションや、Webフロントエンドのビルドツールと格闘してきたエンジニアなら、この一連の流れの美しさがきっと五感で理解できるはずです。
次回は、こうして最適化・デプロイされたmRNAという実行ファイルを、細胞質という名のランタイム環境(JVMやV8エンジン)で実際に動かす、第7章の後半「翻訳(ランタイム編)」へ進みます!
それでは、また次回のビルドでお会いしましょう!