みなさん、こんにちは。64歳のプログラマーです。
未来の予約投稿枠として、教科書第10章の「DNAテクノロジー」のハック連載をすべてリポジトリにコミット(書き溜め)し終えました。ブログの定期デプロイ(予約更新)インフラが整ったところで、今回はカレンダーを「現在(8月12日)」に巻き戻し、リアルタイムの受験ドキュメントをお届けします。
現在の私は、9月下旬の出願、そして10月の試験本番に向けて、提出必須書類である「小論文(研究計画書)」の最終リファクタリング(推敲)という名の修羅場に身を置いています。
専門家からの愛のある(手厳しい)コードレビューを経て、私の研究計画がどう磨かれていったのか、そのリファクタリング戦略を公開します。
1. バグ報告:手段が目的になっていた初期コード
私の最初の研究計画のコード(下書き)は、以下のようなロジックでした。
- 【初期の仕様案】:「30億文字のゲノムデータから、がん化の原因となる異常(メチル化)を、私の持つ高速なC言語アルゴリズムを用いて超スピーディに検出するシステムを開発する」
これに対する、バイオインフォマティクスの先輩方からのレビューコメントは非常に冷徹でした。
「プログラミングが速いのはわかった。でも、既存のPythonやRのライブラリではなく、なぜ今さら君のC言語で低レイヤから叩く必要があるの?解き明かしたい生物学的な問い(バグ)は何?」
完全に「技術のスタンドプレー(手段の目的化)」というコンパイルエラーを起こしていたのです。大学院の試験官が求めているのは、プログラマーとしての自慢ではなく、「研究者としてのドメイン知識」でした。
2. リファクタリング:目的関数を「生物学的バグの解明」へ再定義
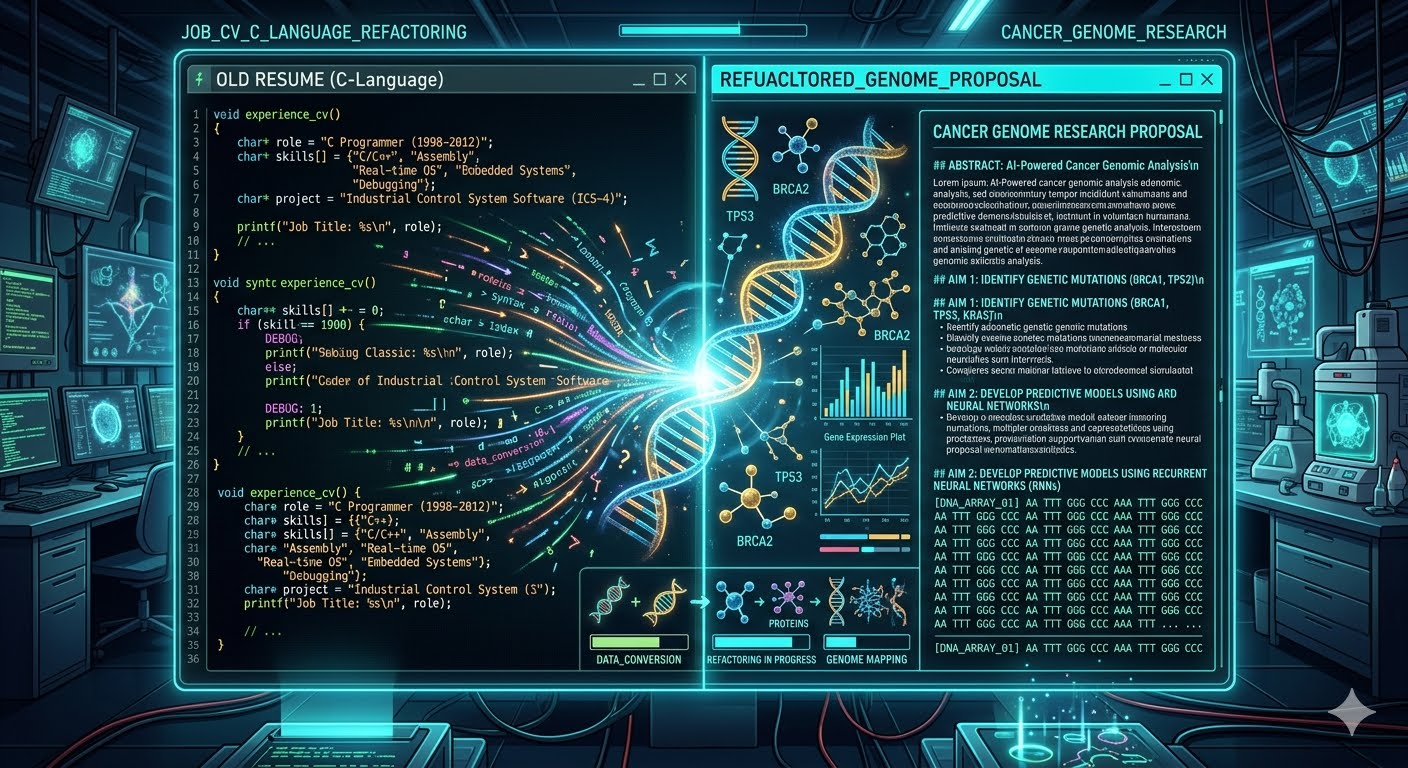
そこで、研究計画書のロジックを根本から書き換え、目的関数を「技術アピール」から「バグの原因究明」へとリファクタリングしました。
- 【修正後の仕様案(リファクタリング後)】:
「現在のがんゲノム解析(ドライ解析)において、特定のプロモーター領域で起きる微細なメチル化(がん抑制遺伝子のコメントアウトバグ)は、既存のバルク解析ツールではノイズに埋もれて検出が難しい。
ここに、私の40年のITキャリアで培った『限られたメモリ空間で巨大なテキストデータをパース(解析)する低レイヤの最適化技術』をコンバートする。これにより、ノイズを極限までカットし、隠れたバグを高精度に検出する新たなデータ解析パイプラインを構築する」。
自分のスキル(C言語)を主役に置くのではなく、「バイオの未解決問題をクリアするための最強のライブラリ(手段)」としてコードをパッチ当てしたわけです。これでようやく、試験官の環境でも正常に実行(ビルド)できる、説得力のある書類になりました。
3. 未履修からの挑戦:10月の本番(ストレステスト)へ向けて
64歳からの挑戦は、確かに新しい関数(生物学の専門知識)を脳内メモリにインポートする連続で、毎日バッファオーバーフロー寸前です。
しかし、長年のエンジニア生活で叩き込まれた「仕様書の矛盾を見つけ、原因を特定し、デバッグする力」は、がんゲノムという巨大なプログラムを相手にしても、何一つ変わりません。
書類という名の仕様書はピカピカに仕上がりました。
ここからは、9月下旬の出願に向けて誤字脱字のLinter(校正)をかけつつ、10月の本番で行われる「面接・口頭試問」という名の、試験官による過酷なストレステスト(圧迫レビュー)を耐え抜くための想定問答集を作り込んでいきます!
人生最大規模のバージョンアップ、絶対にマスターブランチにマージさせてみせます。応援よろしくお願いいたします!
次回のリアルタイム報告もお楽しみに!