みなさん、こんにちは。64歳のプログラマーです。
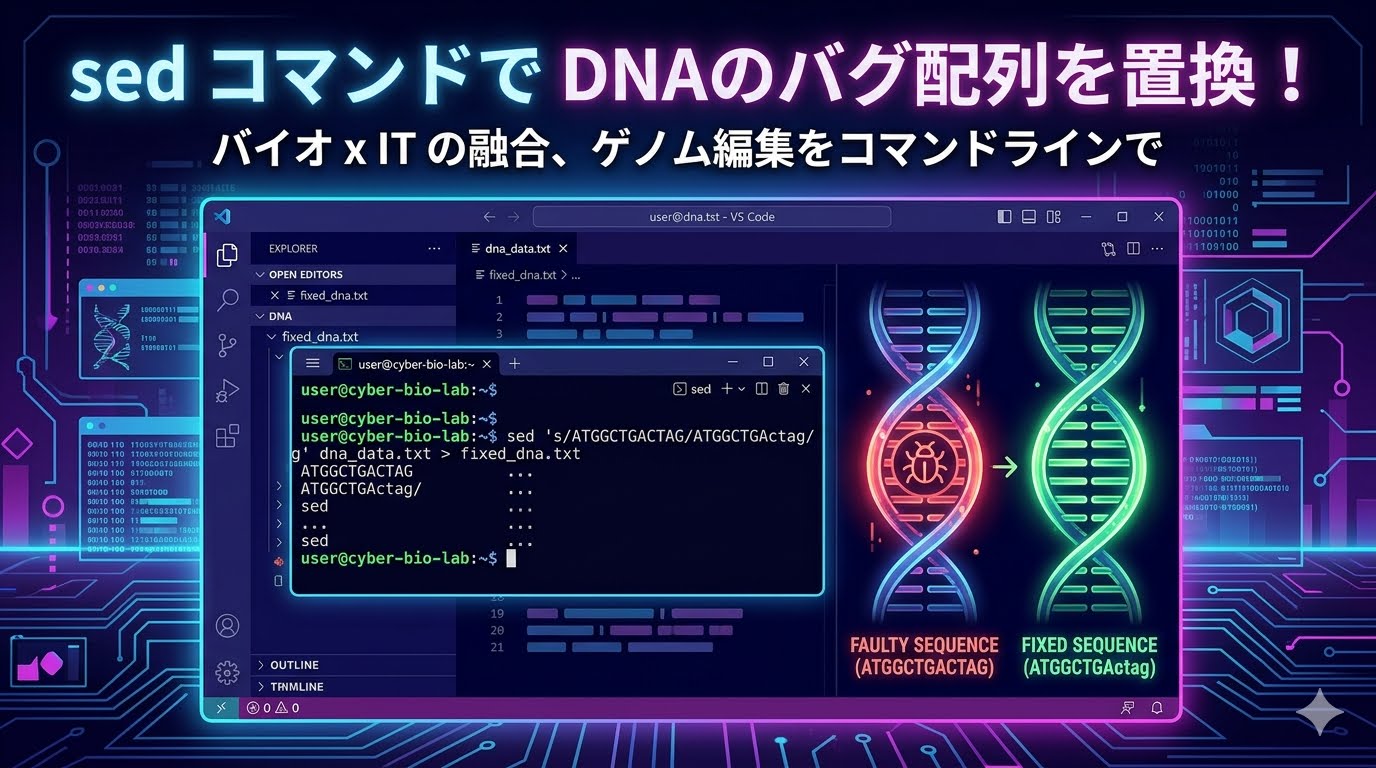
前回までは、DNAの仕組みやゲノム編集を「ソースコードの書き換え」に例えて解説してきました。今回からは番外編として、私が今まさに猛勉強している「バイオインフォマティクス(生物情報科学)」の世界へ突入します!
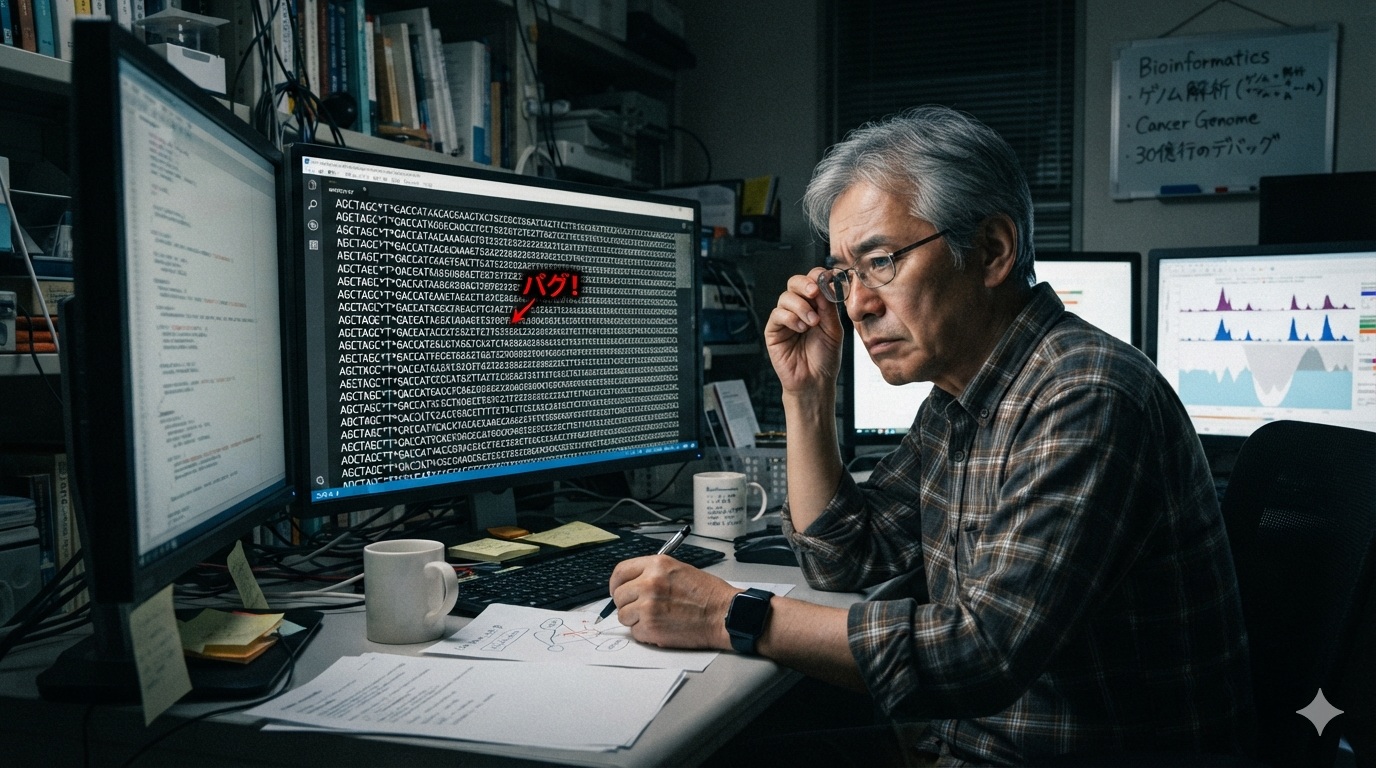
一言で言うと、がんゲノム解析の現場は、エンジニアにとって「究極のデバッグ環境」でした。
📂 1. 次世代シーケンスデータは「壊れた巨大ログファイル」
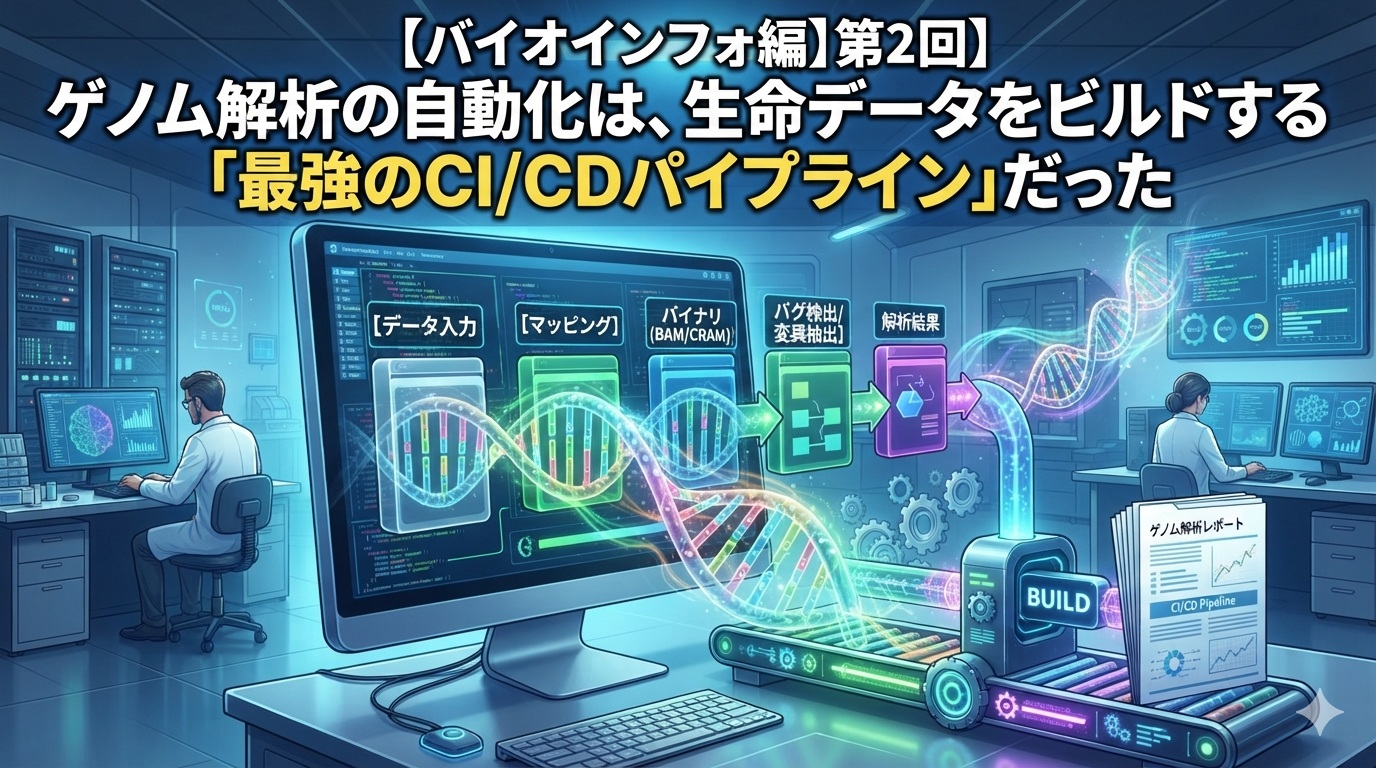
がん細胞のDNAを解読すると、「FASTQ」というテキスト形式のデータ(ファイルサイズは数十〜数百GB!)が吐き出されます。
プログラマーの感覚で言うと、これは「数億行に分割され、シャッフルされたログファイル」です。しかも、解読エラーという「文字化け(ノイズ)」が大量に混ざっています。
- ITで言うと: サーバーがクラッシュした際、バラバラに砕け散った数億行の未整理ログ。
- バイオでは: 30億塩基のDNAが、100〜150文字ずつの断片(リード)としてランダムに出力された状態。
ここからデバッグ(解析)が始まります。
🗺️ 2. マッピング作業は、超巨大な「文字列検索(grep)」
バラバラのログファイルを、まずは「正常な設計図(ヒトゲノムの標準配列)」と照らし合わせて、どこに位置するデータなのかを特定します。この作業をマッピング(アライメント)と呼びます。
30億文字の巨大なテキストに対して、数億件の断片を高速で検索してパズルのようにハメていくわけです。
- ITで言うと: 数億個の単語を、30億文字の辞書から一瞬で高速検索する
grep処理。 - バイオでは:
BWAやBowtie2といった専用ツール(背後では「バローズ・ホイラー変換」という超高度なデータ圧縮・検索アルゴリズムが動いています)を使った高速マッピング。
C言語で文字列検索エンジンをカリカリにチューニングしたことがある人なら、このアルゴリズムの美しさに間違いなく悶絶します。
🐛 3. 変異検出(バリアントコール)=「バグ(NullPointer)の特定」
マッピングが終わると、データは「BAM」というバイナリ形式にコンパイル(変換)されます。
いよいよここから、がんの原因となった遺伝子の「バグ」を探します。
正常な設計図のコードが A(アデニン) なのに、がん細胞のコードが T(チミン) に変わっているような場所を検知するシステム。これがバリアントコールです。
- ITで言うと: 正常に動く本番環境と、バグ落ちした環境のバイナリの
diffを取る。 - バイオでは: 30億文字の中から、たった1文字の書き換わり(一塩基バリアント:SNV)を突き止める。
システムのクラッシュを引き起こした「たった1行のスペルミス(タイポ)」を見つけた瞬間のあの脳汁、あれががん研究の現場でも全く同じように味わえるのです。
🚀 今回のハックまとめ
がんゲノム解析とは、「30億文字のスパゲッティコードから、文字化けノイズを取り除き、クラッシュの原因となった1文字のタイポを突き止める」という、プログラマーの本能を刺激する最高にエキサイティングなデバッグ作業でした。
次回は、この大量のデータを処理するLinuxパイプラインについて、プログラマー目線でデバッグしていきます。お楽しみに!